Как устроен поиск внутренних документов и где появляется ручная работа
Внутренний поиск — это не просто строка, куда сотрудник вводит название файла. Обычно человеку нужно найти конкретный факт среди договоров, регламентов, инструкций, протоколов встреч, коммерческих предложений и переписки. При этом он может не знать, как называется документ, где тот хранится и кто его создал.
Например, менеджеру нужно проверить, какой срок согласования указан в договоре с поставщиком. Он открывает несколько папок, просматривает версии файлов, ищет нужный пункт и уточняет, не было ли дополнительного соглашения. Само чтение занимает несколько минут, но перед ним идёт целая цепочка мелких действий: понять, где искать, подобрать формулировку запроса, отсеять похожие документы и проверить актуальность найденного.
Часть нагрузки возникает из-за устройства корпоративных данных. Один отдел хранит файлы на общем диске, другой — в облачном хранилище, третий прикладывает документы к карточкам CRM. Названия не всегда единообразны. В одной папке лежит «Регламент продаж», в другой — «Новый регламент продаж», а рядом может находиться файл «Регламент продаж финал 2».
Создание ИИ-агента для такого процесса означает разработку программного помощника, который получает рабочий запрос, самостоятельно выполняет несколько связанных действий и возвращает результат в заданном формате. В случае с документами он может определить смысл запроса, обратиться к разрешённым источникам, найти подходящие фрагменты и подготовить ответ со ссылками на исходные файлы.
Здесь важно правильно видеть предмет автоматизации. Агент не «знает документы компании» сам по себе. Он работает с теми материалами, к которым ему дали доступ, и по тем правилам, которые для него задали. Поэтому качество поиска зависит не только от языковой модели, но и от порядка в источниках, метаданных, прав доступа и понятных критериев актуальности.
Какие действия можно передать агенту и чем этот подход отличается от обычного поиска
Обычный поиск чаще всего сопоставляет слова из запроса со словами в названии или тексте файла. Если сотрудник ищет «условия расторжения», а в договоре используется формулировка «досрочное прекращение обязательств», нужный документ может не попасть в верхнюю часть выдачи.
Поиск по смыслу работает иначе. Система сравнивает не только точные слова, но и содержание запроса с содержанием фрагментов документов. Это помогает находить материалы, в которых та же мысль сформулирована другими словами. Такой подход особенно полезен, когда сотрудник помнит суть, но не знает официального термина или точного названия файла.
Однако один смысловой поиск ещё не делает систему агентом. Поисковый механизм возвращает подходящие фрагменты, а агент может выстроить из них рабочую последовательность. Например: уточнить подразделение и период, проверить несколько хранилищ, исключить архивные версии, сопоставить основной договор с приложениями и собрать краткую справку с источниками.
От чат-бота агент отличается не внешним видом диалога, а способом работы. Чат-бот может отвечать на вопросы по заранее подготовленной базе. Агент получает цель и выполняет цепочку разрешённых операций, включая обращения к разным системам. Подробнее базовую разницу я разобрал в статье «Что такое ИИ-агент для бизнеса».
От обычной автоматизации подход отличается гибкостью маршрута. Классический сценарий хорошо выполняет жёсткое правило: если появился файл определённого типа, переместить его в нужную папку. Агент полезнее там, где запросы сформулированы свободно, а для ответа нужно выбрать действия по ситуации. При этом чёткие операции — проверку прав, фильтрацию по дате или открытие карточки документа — по-прежнему лучше выполнять обычным программным кодом.
Какие задачи подходят агенту, а где решение должен принимать человек
Хороший кандидат для передачи агенту — повторяющийся информационный запрос, ответ на который уже содержится во внутренних материалах. Например, поиск пункта договора, подбор актуальной инструкции, сбор связанных протоколов, сравнение двух редакций документа или подготовка списка источников по теме.
Также агент может делать предварительную работу: классифицировать найденные файлы, выделять совпадения и расхождения, составлять краткое содержание, отмечать недостающие сведения. Это сокращает объём ручного просмотра, но не превращает предварительный результат в окончательное управленческое решение.
Плохо подходят задачи, где документ допускает неоднозначное толкование, а ошибка ведёт к юридическим, финансовым или кадровым последствиям. Агент может найти положения договора и показать связанные приложения, но решение о расторжении принимает ответственный специалист. Он может собрать внутренние правила по премированию, но не должен самостоятельно определять выплату конкретному сотруднику.
Человеку также нужно оставить выбор, если источники противоречат друг другу, статус версии неясен или в базе нет достаточного подтверждения ответа. В таких случаях корректное поведение агента — не заполнить пробел правдоподобным текстом, а показать неопределённость и передать вопрос на проверку.
Отдельный риск связан с доступом. Сотрудник не должен получать через агента документ, который он не мог бы открыть напрямую. Поиск не отменяет разграничение прав между отделами, проектами и должностями. То же относится к действиям: если агент умеет не только читать, но и менять, отправлять или удалять материалы, каждое такое полномочие требует отдельного обоснования.
Практичная граница проходит между подготовкой информации и ответственным решением. Чем выше цена ошибки и сложнее исправить последствие, тем меньше автономности стоит давать системе.
Какие данные, правила и интеграции нужны системе
Основа системы — источники документов. Это могут быть сетевые папки, облачные диски, корпоративный портал, CRM, база знаний или система электронного документооборота. Интеграция — это программное подключение, через которое агент получает разрешённый доступ к содержимому и служебным сведениям.
Одного текста файлов недостаточно. Полезны метаданные: автор, отдел, дата, тип документа, статус, номер договора, связанный проект и признак актуальной версии. Они помогают отличить действующий регламент от архива и договор одного контрагента от похожего документа другого.
Перед поиском материалы обычно индексируют: подготавливают структуру, по которой система быстро находит подходящие части текста. Большие документы делят на фрагменты, сохраняя связь со страницей, разделом и исходным файлом. Благодаря этому ответ можно сопровождать не общей ссылкой на длинный документ, а указанием на конкретное место.
Следующий слой — правила. Нужно определить, какие источники участвуют в поиске, как выбирать актуальную редакцию, какие документы имеют приоритет при противоречии и в каких случаях агент обязан отказаться от ответа. Формат результата тоже лучше задать заранее: краткий ответ, цитируемый фрагмент, название файла, дата версии и ссылка на источник.
Права доступа должны проверяться при каждом запросе, а не только во время первоначальной загрузки документов. Если сотрудника перевели в другой отдел или закрыли ему проект, изменение должно отражаться и в поиске. Для проверки спорных ситуаций полезен журнал действий: какие источники были просмотрены, какие фрагменты использованы и на основании чего сформирован ответ.
Языковая модель в этой конструкции отвечает за понимание запроса и сборку понятного текста. Надёжность же создаёт вся система целиком: подготовленные данные, фильтры, права, правила выбора источников и возможность открыть первоисточник.
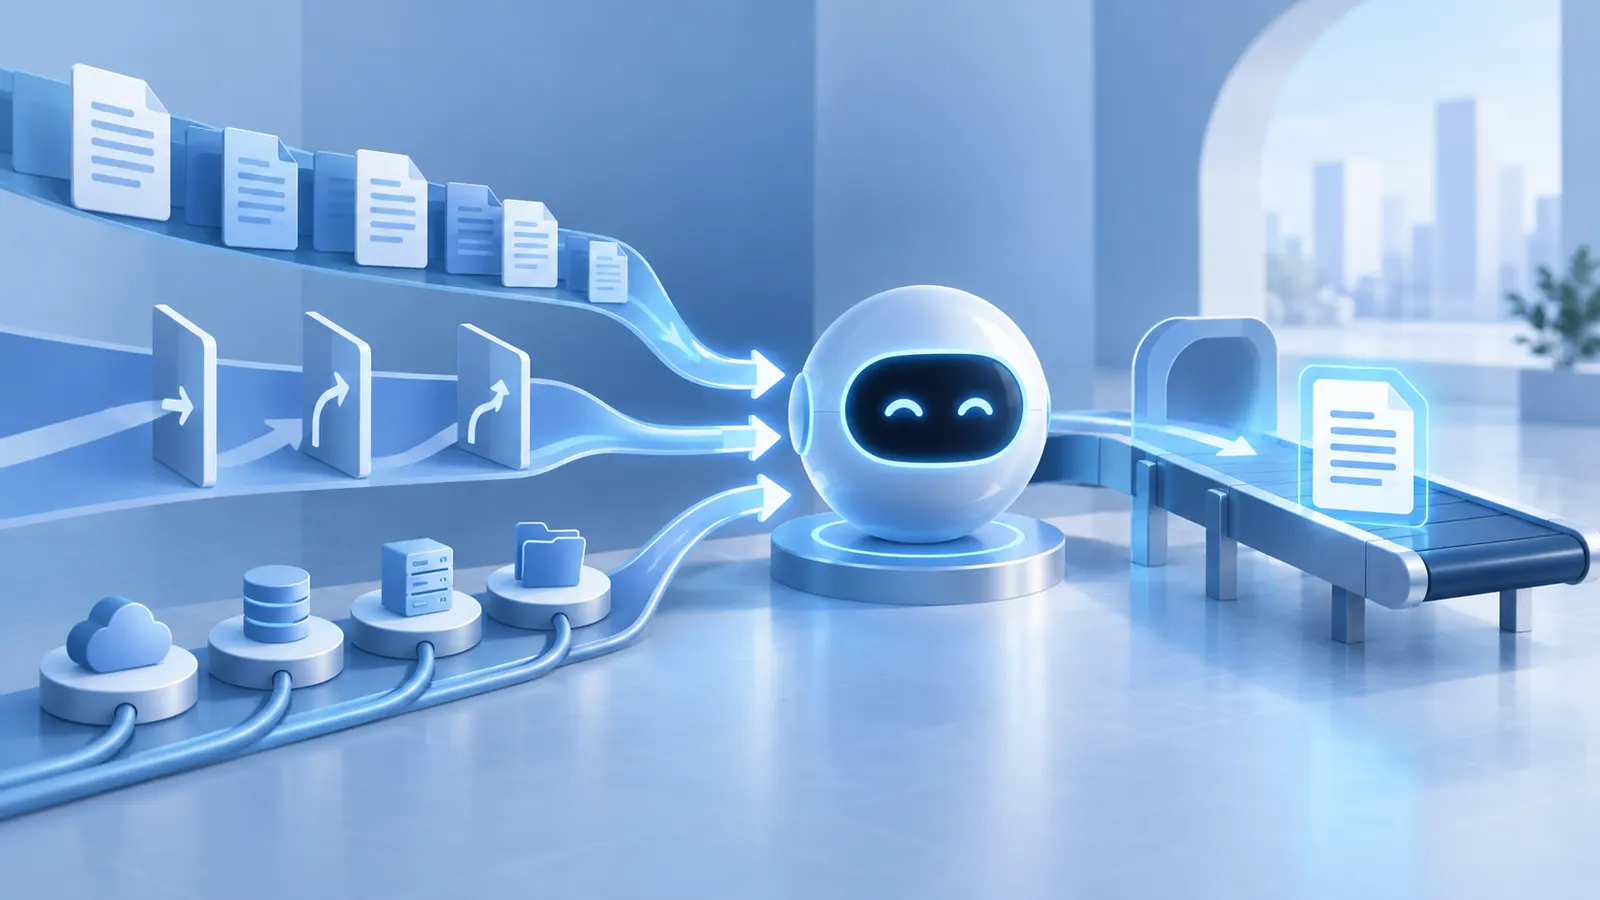
Как выбрать первый сценарий и проверить его на небольшом пилоте
Для пилота лучше взять один ограниченный процесс, одну группу пользователей и понятный набор документов. Попытка сразу подключить все корпоративные хранилища усложняет проверку: если ответы окажутся неточными, будет трудно понять, проблема в данных, правах, поиске или слишком широком сценарии.
Подходящий первый кейс имеет заметный поток однотипных запросов, доступные первоисточники и сотрудника, который умеет оценить правильность ответа. Например, можно проверить поиск по утверждённым регламентам одного отдела или по договорам определённого типа. Если сам процесс ещё не выбран, полезным ориентиром будет материал «Как выбрать процесс для первого AI-пилота».
До запуска стоит подготовить набор реальных вопросов без конфиденциальных данных, которые не должны участвовать в тесте. Для каждого вопроса нужен проверенный эталон: правильный документ, нужный фрагмент и допустимый ответ. Затем результаты можно оценивать по нескольким критериям: найден ли верный источник, указана ли актуальная версия, подтверждается ли ответ текстом, соблюдены ли права доступа и распознаёт ли система ситуацию, когда сведений недостаточно.
Скорость тоже имеет значение, но её нельзя оценивать отдельно от качества. Быстрый неправильный ответ только переносит ручную работу с поиска на исправление ошибок. Полезнее сравнить весь путь: сколько времени человек тратил раньше, сколько занимает проверка ответа агента и в какой доле запросов всё равно приходится искать материал заново.
Первый шаг можно сделать без большого проекта: выбрать двадцать–тридцать типичных вопросов по одному массиву документов и вручную зафиксировать правильные источники. Если вопросы повторяются, ответы можно объективно проверить, а ошибки не запускают необратимых действий, идея подходит для пилота. Если даже эксперт не может уверенно определить актуальный документ, начинать стоит не с агента, а с порядка в данных.