Как устроена проверка ответов и откуда берётся ручная нагрузка
Под проверкой ответов я понимаю рабочий процесс, в котором входящее сообщение сопоставляют с заданными критериями, находят ошибки или отклонения и фиксируют результат. Ответом может быть выполненное учебное задание, сообщение сотрудника клиенту, заполненная анкета, заявка подрядчика, комментарий оператора или текст, подготовленный другой ИИ-системой.
Обычно такая проверка держится на внимательности конкретного человека. Он открывает ответ, вспоминает требования, ищет нужные сведения в документах, отмечает нарушения и формулирует замечание. Если материалов мало, схема выглядит вполне разумно. Сложности начинаются с ростом потока.
Один и тот же критерий приходится применять десятки раз. Часть ответов оказывается типовой, но всё равно требует просмотра. Требования могут храниться в нескольких инструкциях, таблицах и переписках. Проверяющий переключается между ними, а затем вручную переносит итог в CRM, учебную систему, таблицу или задачу для коллеги.
Ручная нагрузка возникает не только из-за количества текстов. Проверка требует постоянной концентрации. В начале дня человек замечает тонкие несоответствия, а после длинной очереди может пропустить очевидную ошибку. У разных специалистов появляются собственные трактовки правил. В итоге качество зависит не только от содержания ответа, но и от того, кто его смотрел, насколько устал и успел ли свериться с последней версией инструкции.
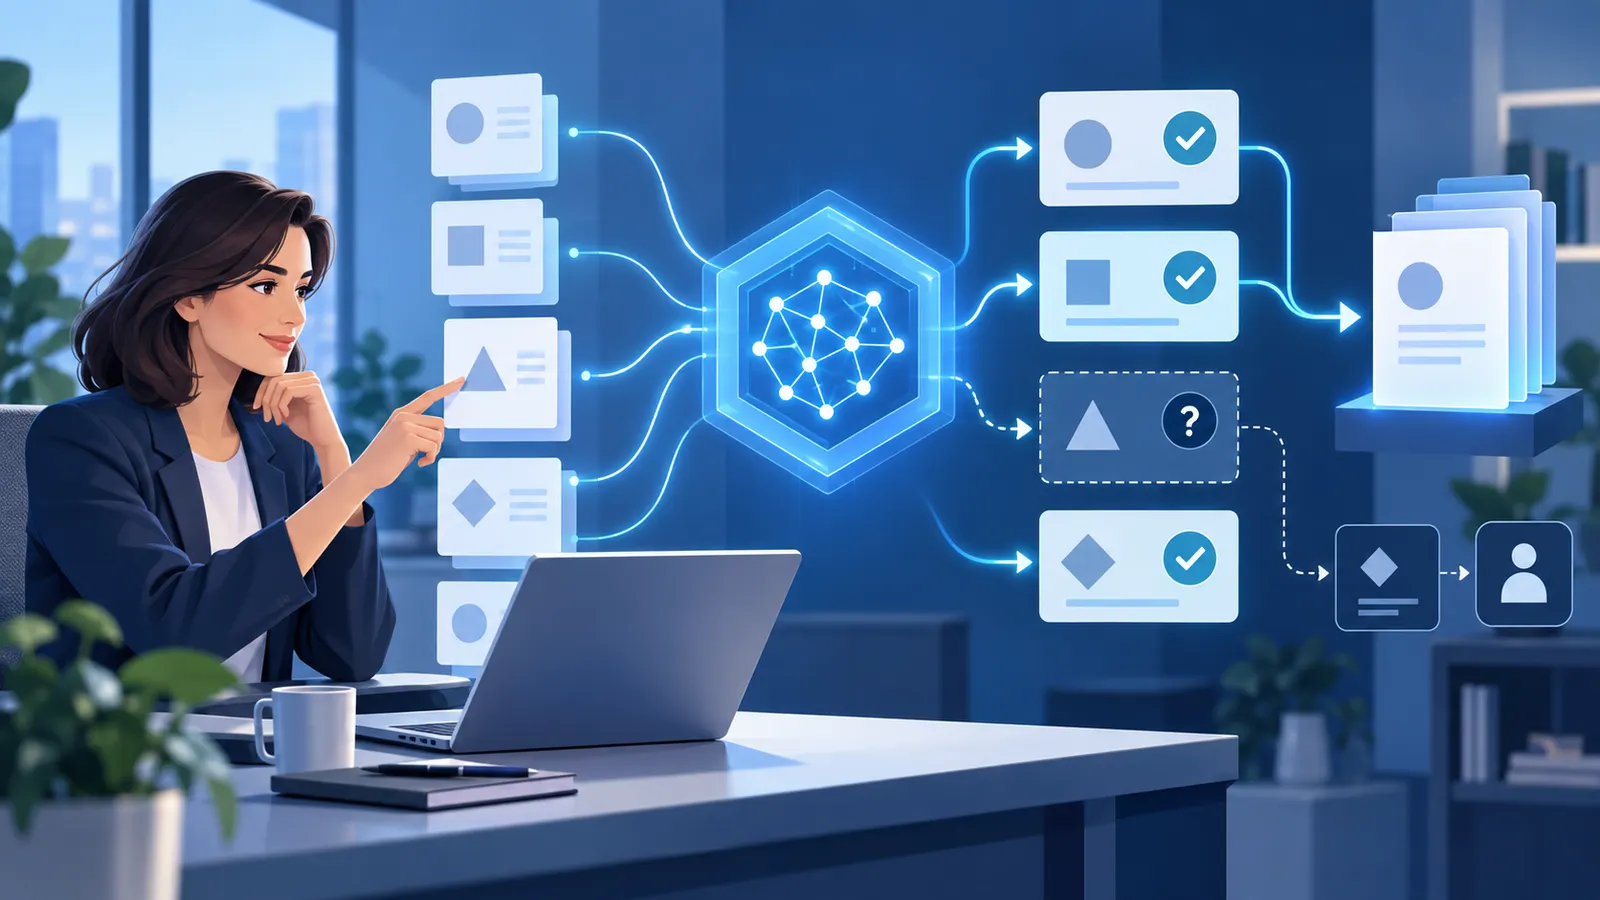
ИИ-агент для проверки ответов — это система, которая получает материал, обращается к нужным правилам и данным, выполняет несколько связанных действий и возвращает структурированный результат. Например, она может выделить спорные места, указать нарушенный критерий и подготовить черновик комментария. Более общее объяснение есть в статье Что такое ИИ-агент для бизнеса.
Какие шаги можно поручить ИИ-агенту
Есть три разных подхода к проверке: полностью ручная работа, обычная автоматизация по жёстким условиям и агентная обработка. Они не исключают друг друга. В хорошем процессе каждый подход занимает своё место.
Ручная проверка подходит там, где нужно понять контекст, намерение автора или возможные последствия решения. Человек способен учитывать неформальные договорённости и замечать исключения, которых нет в инструкции. Цена этой гибкости — время и неодинаковая оценка похожих случаев.
Обычная автоматизация работает по заранее записанным условиям: поле заполнено или нет, есть ли обязательная фраза, совпадает ли значение с допустимым списком. Она быстрая и предсказуемая, но плохо справляется со свободным текстом. Если одну и ту же мысль можно выразить разными словами, простая проверка часто не видит сходства.
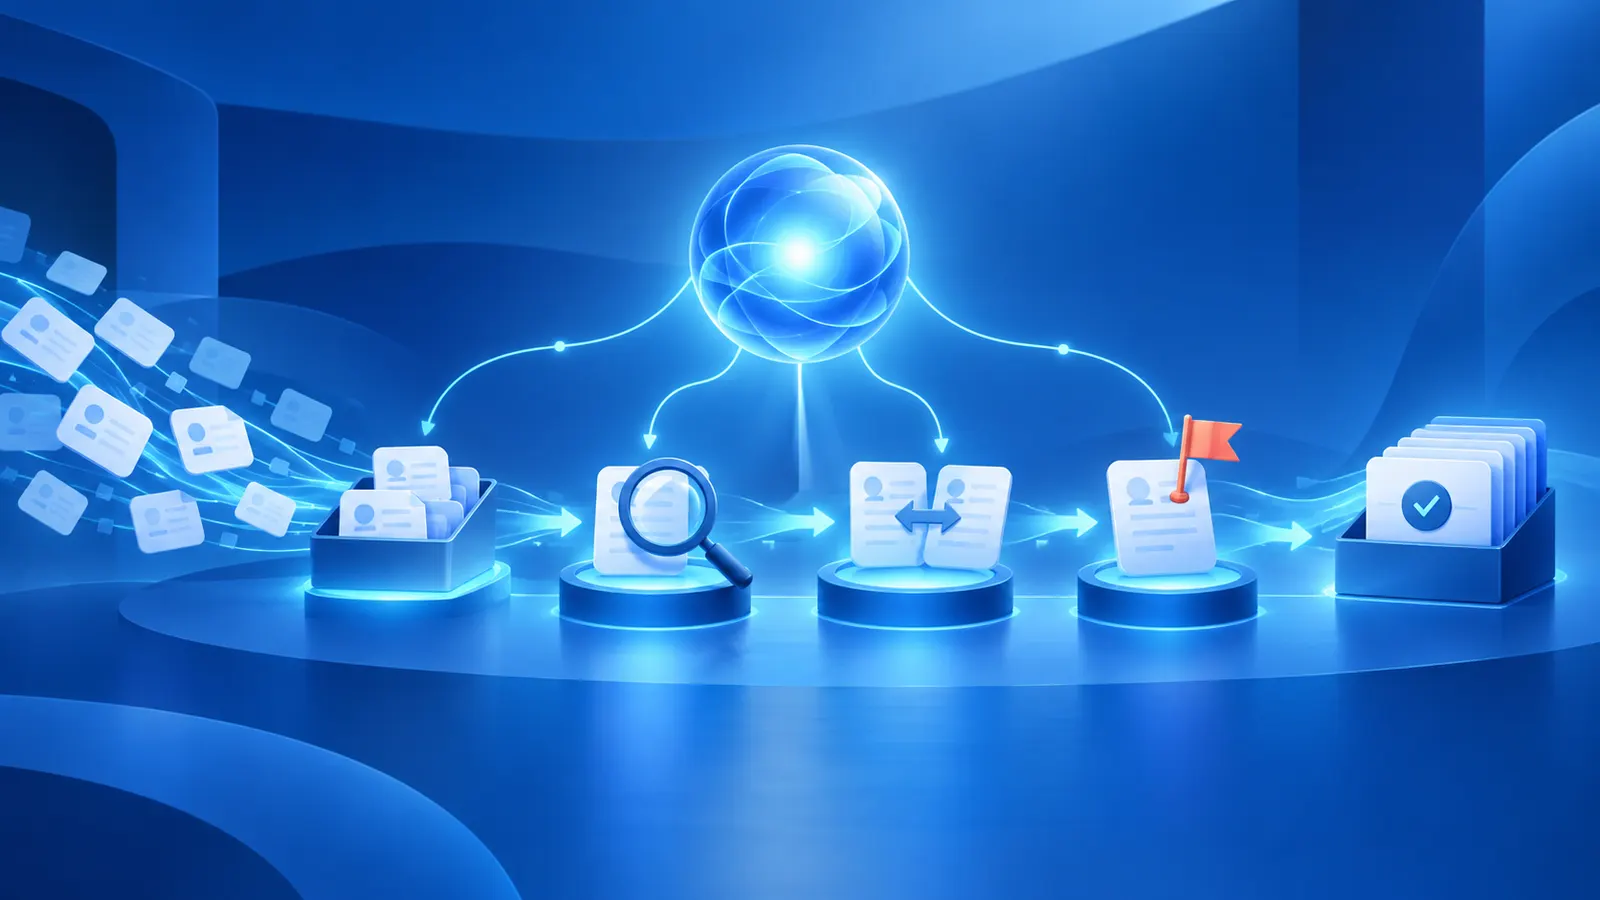
ИИ-агент занимает промежуточное место. Ему можно поручить получение новых ответов из рабочей системы, первичную классификацию, поиск нужного регламента, сопоставление текста с критериями и подготовку заключения по заданному шаблону. Он также может отметить, каких сведений не хватает, найти противоречия между частями ответа и передать сомнительный случай ответственному сотруднику.
От обычного чат-бота такой сценарий отличается самой организацией работы. Чат-бот в основном отвечает на отдельное сообщение пользователя. Агент действует внутри заданного процесса: получает событие, использует доступные источники, проходит последовательность шагов и сохраняет результат там, где с ним продолжат работать.
Это особенно полезно при смешанном потоке. Очевидные ответы можно быстро разложить по категориям, а неоднозначные поднять выше в очереди. Человек тратит внимание не на одинаковый просмотр каждого сообщения, а на те случаи, где действительно нужно разбираться.
Какие задачи подходят агенту и где решение остаётся за человеком
Лучше всего агенту подходят повторяющиеся проверки с понятными признаками хорошего результата. Например, соблюдена ли структура ответа, раскрыты ли обязательные пункты, нет ли противоречия с предоставленными данными, приложено ли обоснование, выдержан ли допустимый тон общения. Полезно, когда итог можно представить в ясной форме: критерий, статус, найденный фрагмент, пояснение.
Подходят и задачи первичного отбора. Агент может разделить ответы на явно корректные, явно неполные и требующие дополнительного просмотра. Ещё один разумный сценарий — не выносить оценку, а готовить проверяющему удобную выжимку: что заявлено, на какие правила это похоже, где обнаружено расхождение.
Плохими кандидатами будут редкие ситуации без устойчивых правил. Если сотрудники сами не могут договориться, какой ответ считать правильным, агент лишь воспроизведёт эту неопределённость. Не стоит отдавать ему окончательные решения, затрагивающие права людей, деньги, санкции, увольнение, медицинские или юридически значимые выводы. Высокая цена ошибки требует осмысленного человеческого решения, а иногда и профильной экспертизы.
Контроль нужен и там, где смысл зависит от скрытого контекста. Формально резкий ответ сотрудника может быть оправдан предыдущей перепиской. Необычная формулировка кандидата может оказаться точнее шаблонной. Уверенный вывод системы сам по себе не доказывает его правильность.
Поэтому границы задают заранее. Агент может рекомендовать статус, но не утверждать его окончательно. Может подготовить замечание, но не отправлять его адресату. Может автоматически закрывать только простые случаи, если для них существуют однозначные правила и предусмотрена выборочная перепроверка. Чем серьёзнее последствия ошибки, тем меньше должна быть самостоятельность системы.
Разработка ИИ-агентов начинается не с попытки заменить проверяющего, а с разделения потока по уровню риска. Машине передают повторяемую подготовительную работу. За человеком сохраняют исключения, спорные трактовки и решения с заметными последствиями.
Какие данные, правила и интеграции нужны системе
Основа системы — не модель сама по себе, а качественное описание проверки. Нужен перечень критериев с понятными формулировками: что считается выполнением требования, какие отклонения допустимы и при каких признаках ответ нужно передать человеку. Полезны примеры корректных, ошибочных и пограничных ответов с объяснением оценки.
Следующий элемент — источник актуальных знаний. Это могут быть регламенты, методические материалы, база знаний, карточка клиента или условия конкретной задачи. Важно определить приоритет документов и следить за версиями. Если две инструкции противоречат друг другу, агенту нельзя предлагать самостоятельно угадывать, какая из них важнее.
Для каждого результата нужен единый формат. Например: идентификатор ответа, проверенные критерии, статус по каждому пункту, подтверждающий фрагмент, краткое объяснение и признак необходимости ручного просмотра. Такая структура помогает сотруднику быстро проверить вывод и сравнивать результаты между собой.
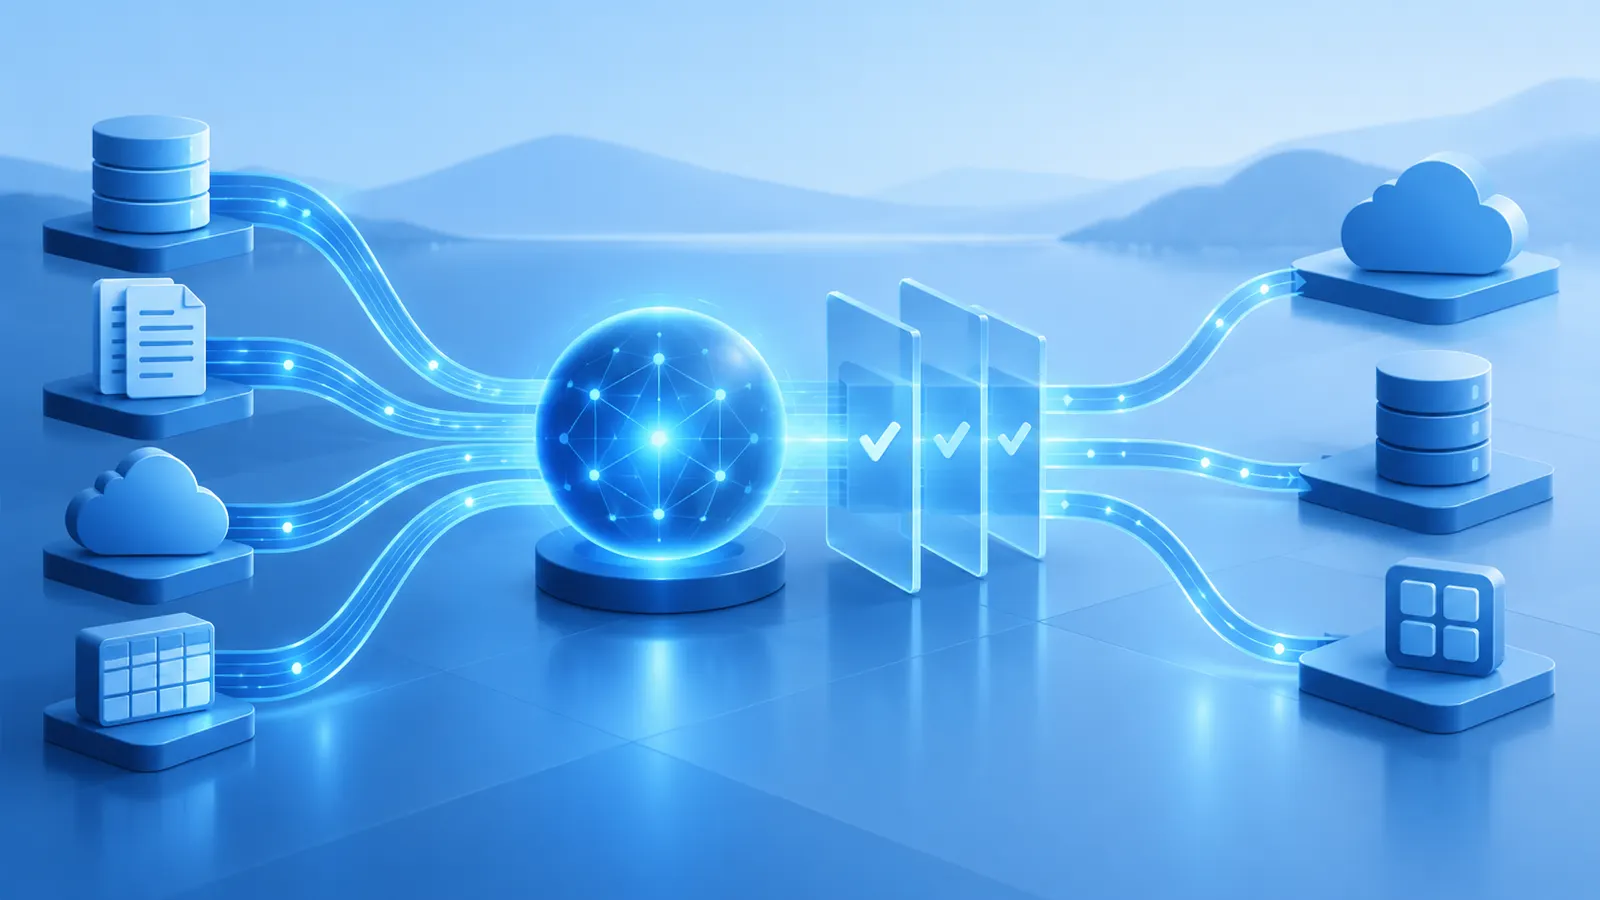
Интеграции связывают проверку с реальной работой. Одна передаёт агенту новый ответ из формы, CRM, почты или внутренней системы. Другая возвращает заключение в карточку, таблицу либо очередь проверяющего. При необходимости подключается уведомление ответственному человеку. API — программный способ обмена данными между системами — часто удобен, но не является обязательным условием первого теста. Для пилота иногда достаточно выгрузки обезличенных примеров.
Отдельно стоит определить доступы, журнал действий и правила хранения. Система должна получать только те данные, которые нужны для проверки. Журнал показывает, какой материал она использовала и какой результат вернула. Это упрощает разбор ошибок и помогает не превращать автоматизацию в непрозрачный механизм.
Как проверить результат на небольшом пилоте
Для первого пилота лучше выбрать один тип ответов и несколько устойчивых критериев. Не весь отдел, не все каналы и не полный регламент. Подходящий участок легко выделить из общего потока, а его результат можно независимо перепроверить. Подробнее логика выбора разобрана в материале Как выбрать процесс для первого AI-пилота.
Сначала полезно собрать набор ранее проверенных примеров. В него должны входить не только очевидно хорошие и плохие ответы, но и пограничные случаи. Затем один и тот же набор оценивают по заранее согласованным критериям и сравнивают заключения агента с контрольной разметкой человека.
Смотреть стоит не на общее впечатление, а на несколько наблюдаемых показателей: сколько нарушений найдено верно, сколько пропущено, сколько корректных ответов ошибочно помечено как проблемные, насколько понятны пояснения и сколько времени занимает перепроверка. Отдельно фиксируют случаи, в которых система уверенно дала неверный результат. Они особенно полезны для уточнения правил.
Пилот можно считать содержательным, если после него понятно, где агент стабилен, где ошибается и какую часть ручной работы действительно снимает. Для проверки своей идеи возьмите один повторяющийся поток, выпишите критерии оценки и вручную отберите несколько десятков разных примеров. Если по ним два опытных сотрудника в основном приходят к одинаковому решению, процесс уже имеет основу для аккуратного теста.