Как сейчас устроена очистка и сверка данных
Очистка данных — это приведение информации к согласованному и пригодному для работы виду. Сверка — проверка того, что записи из разных источников относятся к одним и тем же объектам и не противоречат друг другу. Например, что «ООО Альфа», «Альфа, ООО» и компания с тем же ИНН — один контрагент, а сумма оплаты в банке соответствует счёту в учётной системе.
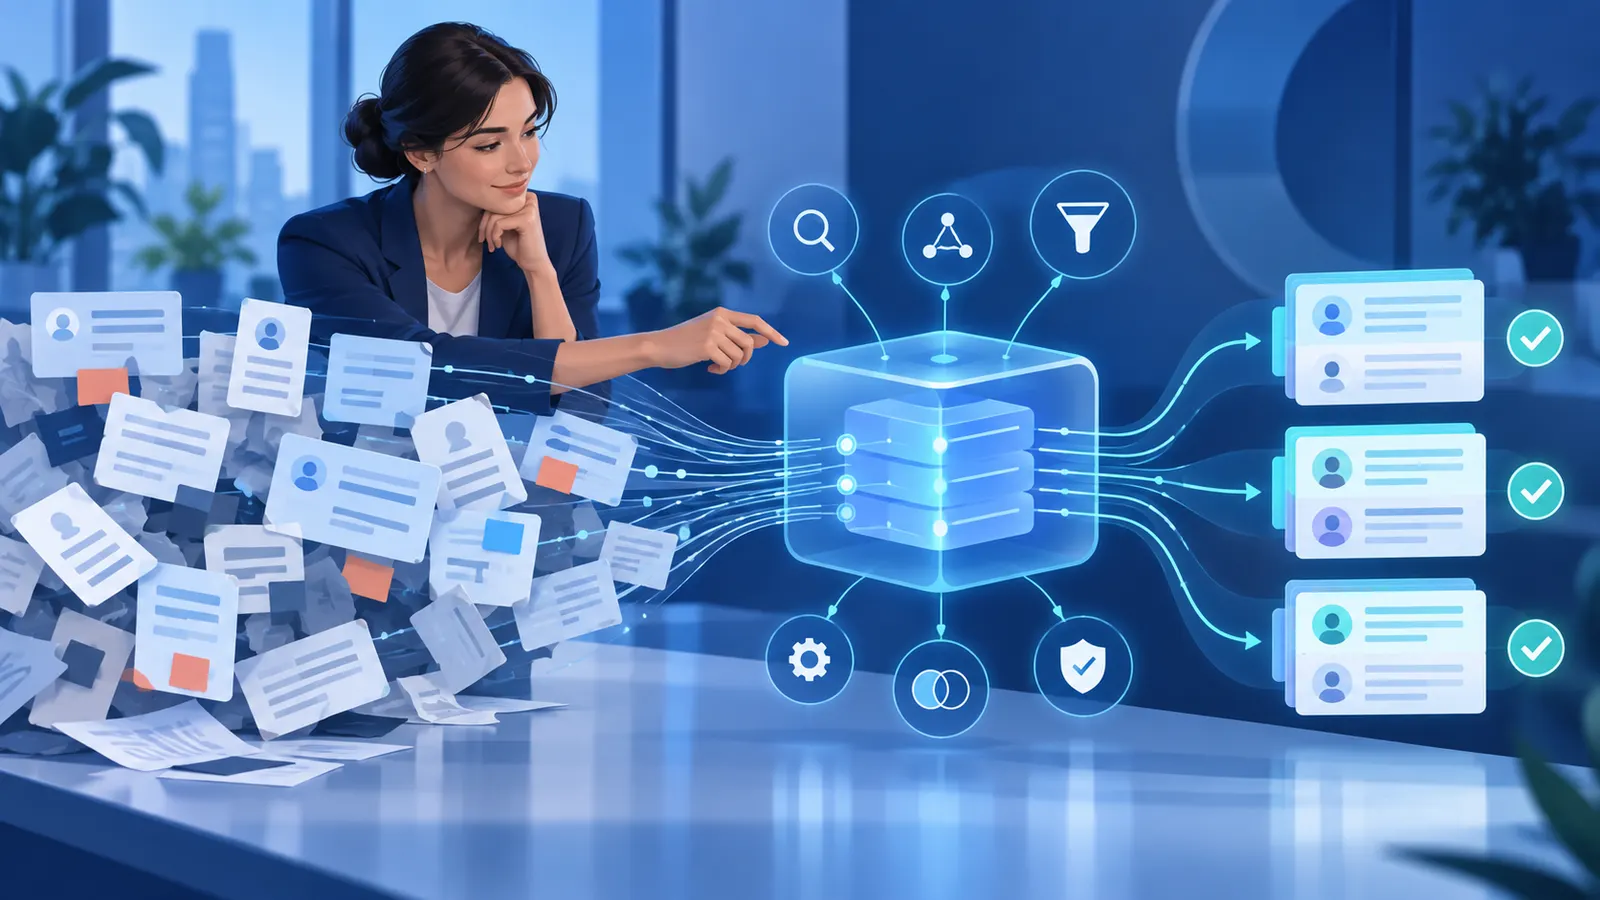
Обычно эта работа распределена между таблицами, CRM, бухгалтерской системой, почтой и личными заметками сотрудников. Менеджер выгружает список клиентов, бухгалтер — платежи, аналитик объединяет файлы и ищет расхождения. Затем кто-то вручную исправляет написание названий, приводит телефоны к одному формату, удаляет дубли и уточняет непонятные записи.
Основная нагрузка возникает не из-за одного сложного действия, а из-за множества мелких решений. Нужно понять, является ли пустое поле ошибкой, можно ли объединить две похожие карточки, почему суммы отличаются и какой источник считать главным. Даже если каждое действие занимает несколько секунд, на большом объёме они складываются в часы однообразной работы.
Проблема усиливается, когда правила существуют только в голове опытного сотрудника. Один менеджер знает, что клиента нельзя определять лишь по названию, другой помнит исключения в номенклатуре, бухгалтер замечает характерные ошибки в назначении платежа. Такой процесс трудно передать, проверить и повторить одинаково.
ИИ-агент в этой задаче — программа, которая получает данные, применяет заданные правила, использует языковую модель для разбора неоднозначных записей, выполняет разрешённые действия и фиксирует результат. В отличие от разового запроса к нейросети, агент работает по сценарию: берёт запись, проверяет её, обращается к нужному источнику и выбирает следующий шаг. Более подробное базовое объяснение есть в статье «Что такое ИИ-агент для бизнеса».
Какие шаги можно поручить ИИ-агенту
Есть три распространённых подхода к обработке данных. Первый — полностью ручной: сотрудник открывает строки, сравнивает значения и вносит исправления. Он гибкий, но плохо масштабируется и зависит от внимательности человека.
Второй подход — обычная автоматизация по жёстким условиям. Например, система удаляет пробелы, приводит даты к единому формату или помечает записи с одинаковым ИНН. Это надёжно там, где заранее известны все правила. Но строгий алгоритм не поймёт, что «Оплата по дог. 18» и «платёж по договору №18 от 12.03» могут относиться к одной операции, если такой вариант не был явно предусмотрен.
Третий подход — агентный. Он сочетает точные правила с разбором менее аккуратных данных. Агент может сначала нормализовать значения, затем найти возможные совпадения, собрать подтверждения из нескольких полей и назначить каждой паре степень уверенности.
Ему можно поручить подготовительные и повторяемые шаги: собрать выгрузки, проверить обязательные поля, привести телефоны и адреса к общему виду, выделить подозрительные значения, найти вероятные дубли. При сверке он способен сопоставлять платежи со счетами, товары из разных каталогов, клиентские карточки или отчёты подразделений.
Практический смысл здесь не в том, чтобы добавить «ум» к каждой строке. Простые преобразования лучше выполнять обычными правилами: так дешевле, быстрее и легче проверить. ИИ полезен на участках, где встречаются свободные формулировки, опечатки, сокращения и неполные совпадения.
Результатом работы агента необязательно должно быть автоматическое исправление исходной базы. Часто полезнее получить три списка: уверенные совпадения, явные ошибки и спорные случаи. Сотрудник видит уже не тысячи строк, а небольшую очередь записей, которым действительно нужна оценка.
Какие задачи подходят агенту и какие данные для них нужны
Подходящая задача должна повторяться и иметь проверяемый результат. Если сотрудники регулярно сопоставляют одни и те же типы записей, а правильность можно подтвердить по нескольким признакам, создание ИИ-агента имеет практический смысл.
Хороший пример — поиск дублей клиентов. Для него могут использоваться ИНН, телефон, электронная почта, адрес и название организации. Совпадение только по названию слабое, а одинаковый ИНН уже даёт гораздо более веское основание. Правила должны описывать не только признаки совпадения, но и их приоритет.
Другой подходящий случай — сверка документов и операций. Здесь нужны номера, даты, суммы, контрагенты, статусы и допустимые отклонения. Если платёж может закрывать несколько счетов или часть одного счёта, это тоже должно быть отражено в логике проверки.
Агент плохо подходит для процесса, в котором сотрудники сами не могут договориться, что считать правильным результатом. Если одинаковые ситуации каждый раз решаются по-разному, модель не устранит неопределённость. Она лишь сделает её менее заметной.
Особенно осторожно стоит относиться к необратимым действиям: удалению записей, объединению клиентских карточек, изменению финансовых документов и присвоению юридически значимых статусов. Здесь ошибка может повлиять не только на отчёт, но и на отношения с клиентом, расчёты или обязательства компании.
Поэтому риск и уровень контроля лучше связывать с уверенностью и ценой ошибки. Очевидное форматирование можно выполнять автоматически. Вероятные совпадения — предлагать человеку на подтверждение. Случаи с недостаточными данными — оставлять без изменений и передавать ответственному сотруднику.
Нужны и отрицательные примеры: записи, которые выглядят похожими, но относятся к разным объектам. Они помогают обнаружить опасные упрощения. Два человека могут иметь одинаковые фамилии, компании — похожие названия, а платежи — одинаковые суммы. Чем дороже неверное объединение, тем сильнее должны быть подтверждающие признаки.
Из чего состоит система и где остаётся решение человека
Рабочая схема начинается с источников. Это могут быть CRM, учётная программа, база данных, облачные таблицы или загружаемые файлы. Интеграция означает технический способ получить из них записи и, если это разрешено, вернуть результат. Иногда достаточно регулярной выгрузки, а иногда требуется API — программный канал обмена между системами.
Следующий слой — подготовка. Он проверяет структуру файла, названия столбцов, типы значений и обязательные поля. После него применяются точные бизнес-правила: форматы, справочники, уникальные идентификаторы и допустимые отклонения.
Языковая модель подключается только там, где нужно разобрать свободный текст или оценить смысловое сходство. Её вывод не стоит хранить как безусловную истину. Вместе с предложением система должна сохранять основания: какие поля совпали, какие различаются и почему запись получила определённую оценку.
Отдельная часть — очередь проверки. В неё попадают случаи, для которых требуется решение сотрудника. Интерфейс может показывать две записи рядом, найденные совпадения и предлагаемый вариант действия. Человек подтверждает объединение, отклоняет его или исправляет предложение.
Полезен журнал изменений: кто или что приняло решение, когда оно было выполнено и какие исходные значения использовались. Он нужен для разбора ошибок и возврата к прежнему состоянию. Без такого журнала даже качественная автоматизация быстро превращается в непрозрачный процесс.
Именно сочетание источников, правил, модели, очереди проверки и журнала образует рабочую систему. Один запрос к нейросети может помочь разобрать файл, но не решает вопросы доступа, повторяемости и ответственности.
Как проверить результат на небольшом пилоте
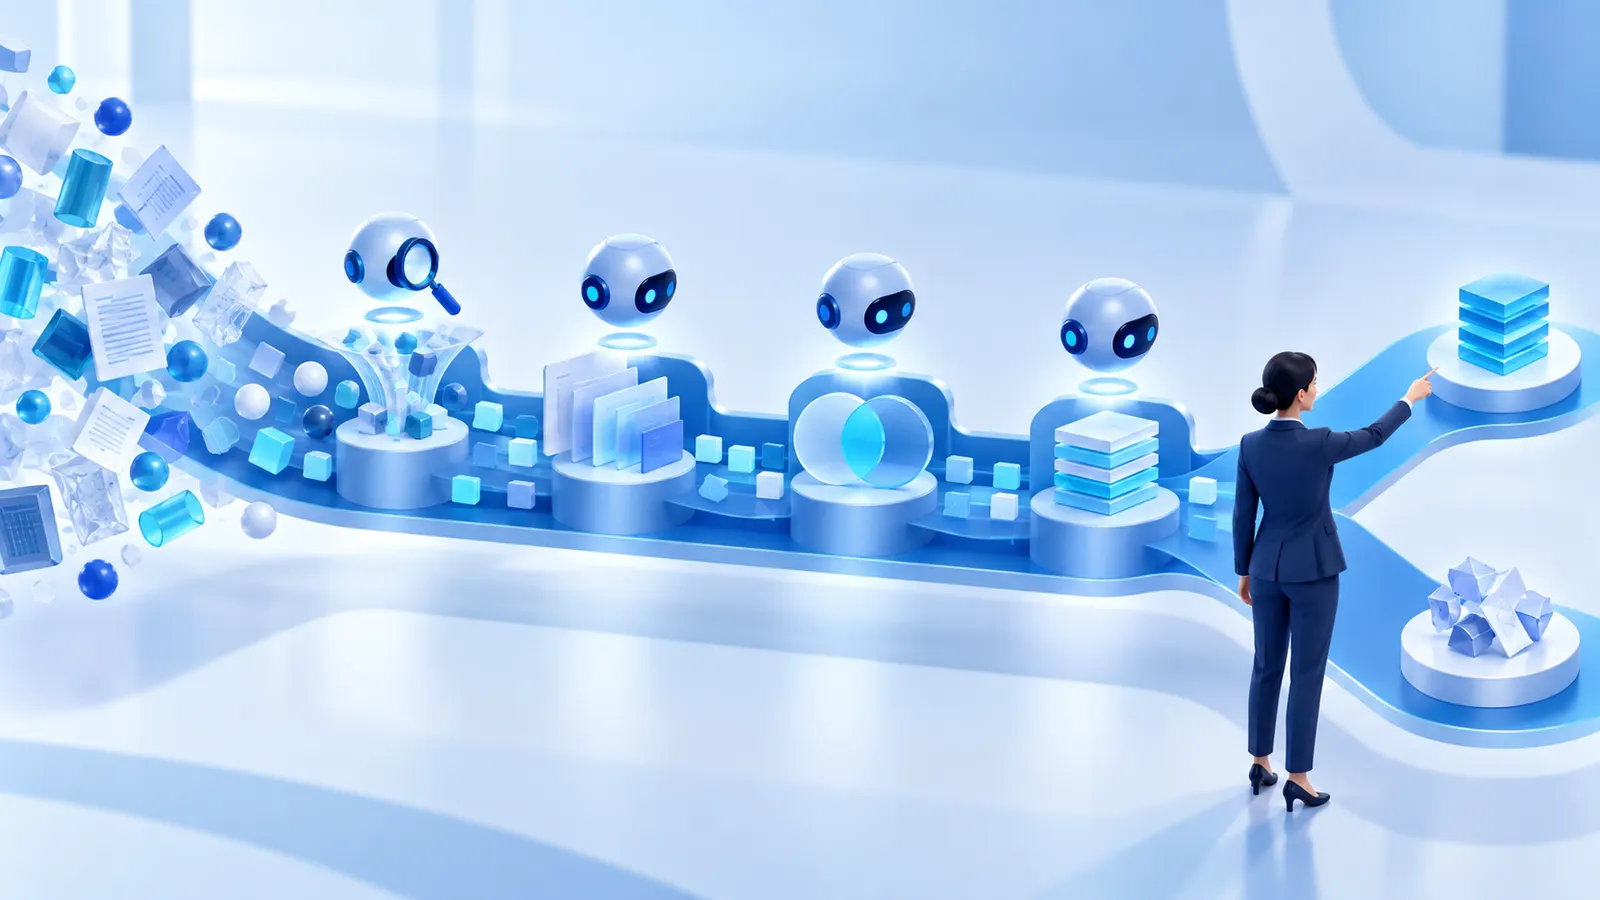
Для пилота лучше выбрать один тип данных и одно измеримое действие. Не «навести порядок в CRM», а, например, найти вероятные дубли среди новых карточек контрагентов. Чем уже граница, тем легче понять, принёс ли подход пользу.
Подходящий процесс встречается регулярно, содержит заметную ручную часть и оставляет эталон для проверки. Эталоном может быть выборка, которую заранее разобрал компетентный сотрудник. Если первый процесс ещё не выбран, полезно пройти критерии из материала «Как выбрать процесс для первого AI-пилота».
Для проверки я бы взял ограниченную копию реальных записей без прямого изменения рабочей базы. В выборке должны быть обычные случаи, известные ошибки и несколько сложных примеров. Иначе пилот покажет красивый результат только на удобных данных.
Оценивать стоит не общую «точность ИИ», а понятные показатели: сколько верных совпадений найдено, сколько ошибочных объединений предложено, какая доля записей отправлена человеку и сколько времени занимает их проверка. Важен и пропуск ошибок: агент может редко ошибаться в своих ответах, но при этом не замечать значительную часть проблем.
До запуска полезно зафиксировать текущую точку: объём выборки, время ручной обработки и типичные ошибки. Тогда результат можно сравнить с исходным процессом, не опираясь на впечатление от демонстрации. Один удачный файл ещё не говорит о стабильности, поэтому проверку стоит повторить на другой выборке того же типа.
Первый практический шаг простой: возьмите недавний набор данных, отметьте в нём решения, которые сотрудник принимает по понятным признакам, и отдельно выпишите спорные случаи. Если большую часть повторяемой работы можно описать правилами, а неоднозначные записи безопасно вынести на подтверждение, процесс подходит для пилота.